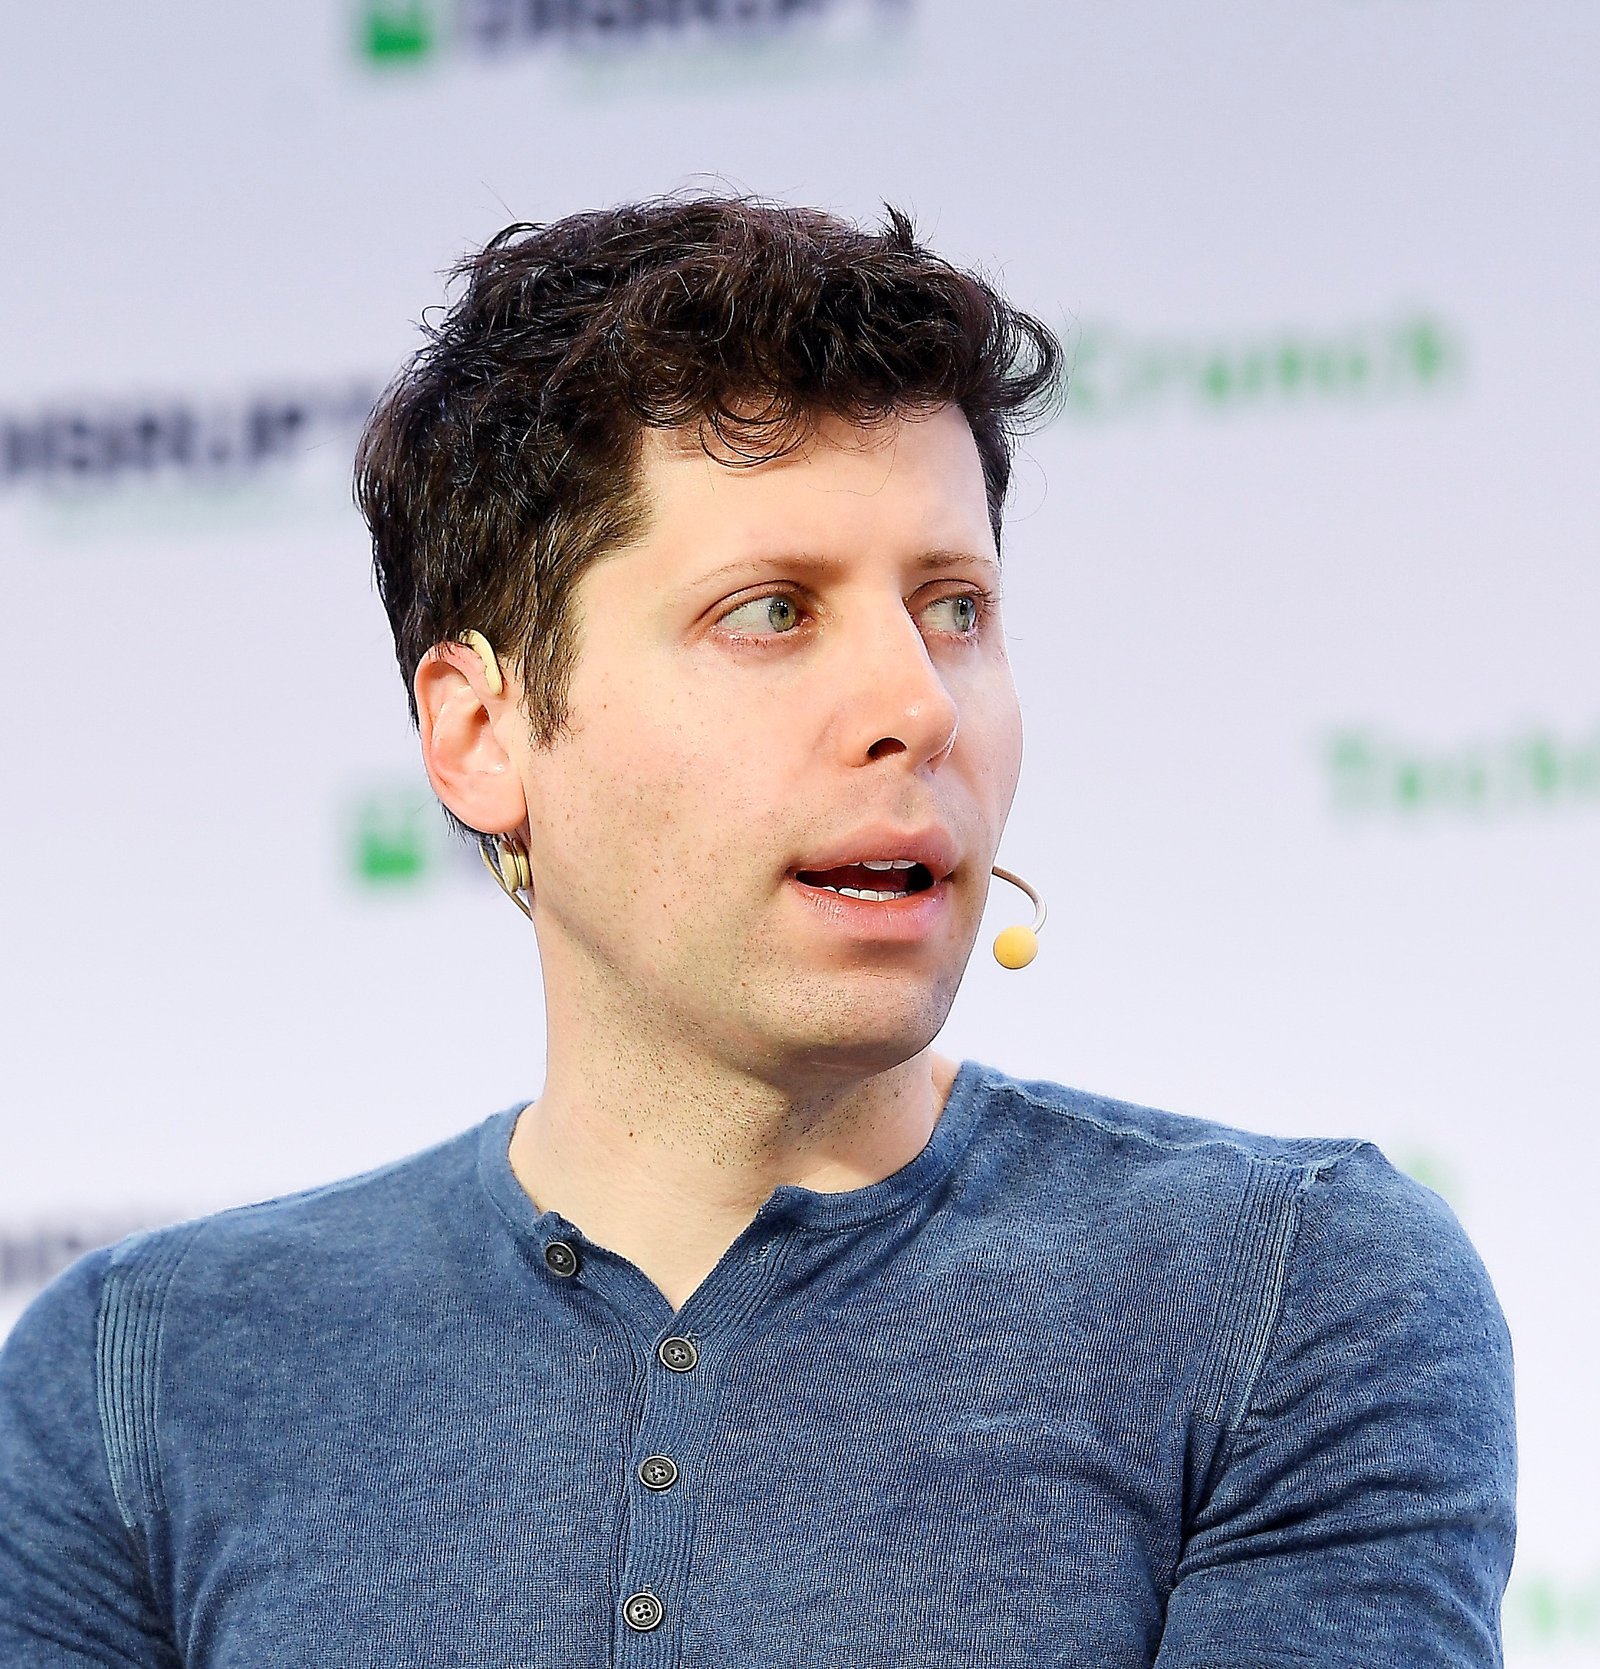
OpenAI ka mbrojtur të premten vendimin për të shkarkuar tre studiues të sigurisë — Jasmine Wang, Tomek Korbak dhe Mikita Balesni — duke thënë se bëhet fjalë për një “shkelje të rëndë besimi” dhe jo për ngritjen e shqetësimeve të sigurisë, siç ishte aluduar fillimisht.
Studiuesit kishin thënë më parë se rregulla të paqarta dhe frika po bllokonin punën e tyre, duke ngritur pikëpyetje mbi mbikëqyrjen e brendshme të laboratorit më të ndjekur të inteligjencës artificiale në botë. Në një postim në X, kompania insistoi se largimi i tyre nuk kishte lidhje me shprehjen e shqetësimeve.
Lëvizja vjen në një moment tensionesh të brendshme rreth ritmit të zhvillimit të modeleve të reja, pas tërheqjes së modelit GPT-6.1 Astra për shkak të problemeve të sigurisë. OpenAI thotë se ushtrimet e përgatitjes për skenarë kritikë, që po zhvillon bashkë me Anthropic, janë mjete planifikimi dhe jo parashikime për incidente reale.
Rasti ka rindezur debatin mbi ekuilibrin mes shpejtësisë së inovacionit dhe sigurisë në laboratorët kryesorë, në një kohë kur modelet e reja po bëhen gjithnjë e më të afta dhe të përhapura në përdorim të përditshëm.
Burimi: ResearchBuzz
Leave a Reply